


|
|
|
|
|
|
|
| zeronhu | profile | guestbook | all galleries | recent | tree view | thumbnails |
Trong một kho dữ liệu lớn, không phải thông tin nào xuất hiện cũng có cùng mức độ quan trọng. Có kết quả chỉ cần ghi nhận để hoàn thiện lịch sử, nhưng cũng có dữ liệu khiến người theo dõi muốn kiểm tra kỹ hơn vì nó liên quan trực tiếp đến câu hỏi đang đặt ra. Nếu không phân biệt được hai nhóm này, quá trình thống kê XSMB dễ rơi vào tình trạng nhìn đâu cũng thấy thông tin đáng chú ý.
Đây là lý do bảng đặc biệt có thể được sử dụng như một lớp tham chiếu trước khi đi sâu vào dữ liệu. Bảng không tự quyết định kết quả nào quan trọng, mà giúp người dùng có đủ thông tin để tự xác định mức độ liên quan. Cách tiếp cận này thay đổi đáng kể cách đọc dữ liệu: thay vì cố tìm điểm nổi bật trong mọi dòng kết quả, người xem bắt đầu từ câu hỏi rồi mới xác định dữ liệu cần chú ý.
 Click nhanh truy cập vào trang bangdacbiet.net để tổng hợp các tin tức mới tại Bảng Đặc Biệt XSMB: Đằng Sau Công Cụ Thống Kê Lịch Sử Chuẩn Xác
Một dữ liệu được xem là đáng chú ý không đơn giản vì nó xuất hiện nổi bật trên màn hình. Mức độ quan trọng còn phụ thuộc vào mục tiêu mà người dùng đang theo dõi. Một kết quả có thể không có gì đặc biệt trong câu hỏi này nhưng lại trở nên cần thiết khi đặt vào một bối cảnh khác.
Trong thống kê giải đặc biệt, điều đầu tiên cần xác định là tiêu chí quan sát. Người dùng muốn kiểm tra một kỳ cụ thể, tìm lại một giai đoạn hay xem xét một nhóm kết quả? Khi mục tiêu rõ ràng, việc phân biệt dữ liệu quan trọng và dữ liệu thông thường sẽ dễ hơn nhiều.
Chẳng hạn, nếu mục đích là xác nhận kết quả của một ngày, những kỳ khác chỉ đóng vai trò tham khảo. Ngược lại, nếu đang xem lịch sử trong một khoảng thời gian, từng mốc trong phạm vi đó đều có giá trị như một phần của tập dữ liệu.
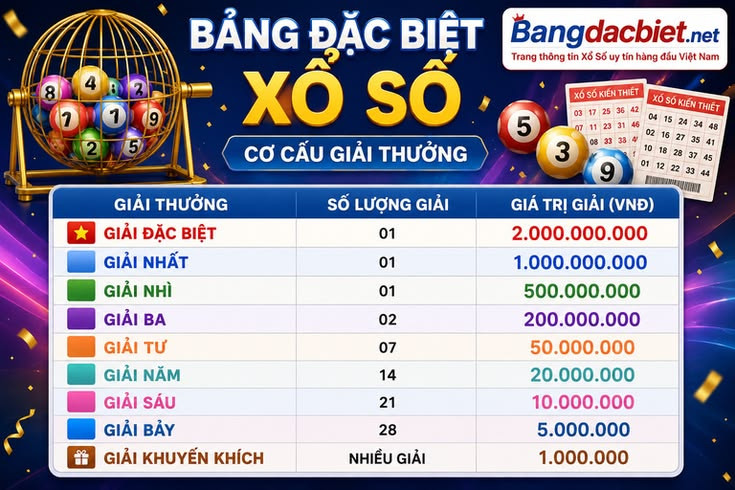
Bảng đặc biệt giúp xác định dữ liệu cần chú ý dựa trên mục tiêu thay vì cảm giác về con số.
Một trong những nguyên nhân khiến người dùng đánh giá sai mức độ quan trọng của dữ liệu là ấn tượng ban đầu. Một kết quả vừa xuất hiện có thể gây chú ý mạnh, trong khi một thông tin khác âm thầm nhưng lại phù hợp hơn với mục tiêu đang kiểm tra.
Trong thống kê giải đặc biệt XSMB, cách xử lý tốt hơn là ghi nhận dữ liệu trước khi đưa ra nhận xét. Bảng đặc biệt cung cấp kết quả, còn người dùng quyết định cách diễn giải sau đó.
Điều này đặc biệt cần thiết khi theo dõi lịch sử dài. Một kết quả quen mắt có thể khiến người xem tưởng rằng nó xuất hiện thường xuyên hơn thực tế. Một kết quả ít gây chú ý cũng có thể bị bỏ qua dù nằm đúng trong phạm vi cần nghiên cứu.
Khi dữ liệu được tích lũy qua nhiều kỳ, việc lọc thông tin trở nên quan trọng hơn việc đơn thuần bổ sung thêm dữ liệu. Một bảng có hàng trăm hoặc hàng nghìn kết quả không nhất thiết phải được xem toàn bộ trong mỗi lần truy cập.
Trong thống kê miền Bắc, người dùng có thể chia dữ liệu thành ba lớp đơn giản: thông tin cần kiểm tra ngay, thông tin có thể tham khảo và thông tin chưa liên quan đến câu hỏi hiện tại. Cách chia này không nhằm loại bỏ dữ liệu. Những thông tin chưa cần dùng vẫn được giữ nguyên trong bảng. Chúng chỉ được đưa ra khỏi vùng tập trung để người xem không bị phân tán.
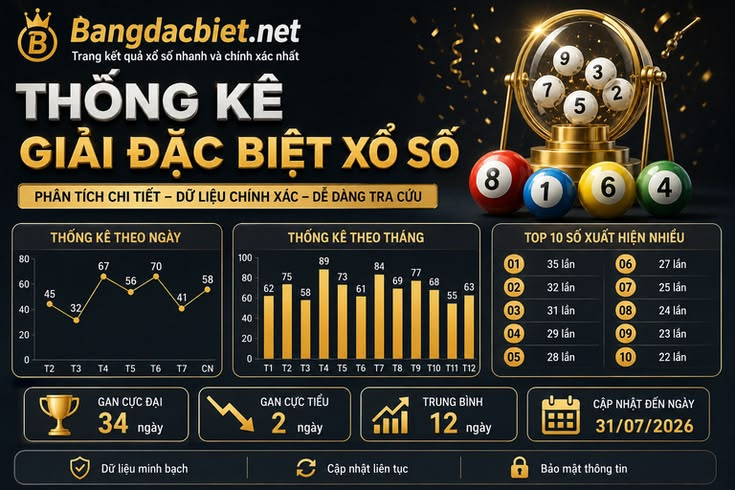
Phân lớp dữ liệu giúp thống kê miền Bắc tập trung vào thông tin phục vụ trực tiếp cho nhu cầu tra cứu.
Một dữ liệu nổi bật chưa chắc là dữ liệu có giá trị cao. Đây là điểm cần đặc biệt lưu ý trong thống kê kết quả xổ số miền Bắc.
Ví dụ, một kết quả có thể được nhắc đến nhiều lần chỉ vì nó mới xuất hiện hoặc tạo ấn tượng mạnh. Nhưng nếu câu hỏi đang đặt ra không liên quan đến kết quả đó, việc tiếp tục theo dõi có thể khiến quá trình thống kê đi lệch hướng.
Ngược lại, một dòng dữ liệu rất bình thường vẫn có thể quan trọng nếu nó nằm trong phạm vi cần kiểm tra. Vì vậy, mức độ nổi bật về mặt thị giác hay cảm nhận không nên được đồng nhất với mức độ liên quan về mặt dữ liệu.
Giá trị của Bảng đặc biệt xổ số miền Bắc không nằm ở việc biến mọi kết quả thành một “tín hiệu”. Giá trị thực tế nằm ở khả năng giúp người dùng nhìn thấy toàn bộ dữ liệu đủ rõ để tự quyết định đâu là phần cần tập trung.
Khi biết phân biệt dữ liệu đáng chú ý với dữ liệu thông thường, quá trình thống kê XSMB trở nên có trật tự hơn. Người xem không cần chạy theo mọi điểm nổi bật, cũng không phải loại bỏ những thông tin chưa dùng đến. Chỉ cần giữ dữ liệu ở đúng vị trí và dành sự chú ý cho phần thực sự liên quan.
Â